LoRA Pipeline 算子节点
在已存在的基础扩散管线上动态叠加非融合式 LoRA 适配层,使同一份常驻显存缓存的模型能够同时为多个不同的生成分支提供算力支持。
算子所属分类:ModularDiffusion/Pipeline
核心速查 (TL;DR)
- 串联于装配器与去噪算子之间:将 Pipeline Builder 输出的管线凭据与一个或多个 Load LoRA 算子连入本节点;随后将本节点的
lora_pipeline输出端代替原管线直接连入 Generate Media Latents; - 按次动态激活与自动卸载:LoRA 权重仅在每一次去噪步进循环前后动态加载挂载,推理完毕立即干净释放——基础主干管线在物理上从未被永久篡改。因此,一份单一的显存底模可以同时驱动两条不同的生成分支(分支 A 挂载 LoRA,分支 B 原生纯净推理)而完全无需重复构建管线;
- 何时优先选用该节点:在多轮测试中频繁微调 LoRA 权重、探索不同的风格组合,或使用 Context-aware (IC) LoRA、蒸馏加速 LoRA (如 LCM/Lightning) 以及面部/表情微调滑块 LoRA 时,强烈推荐使用该节点替代 Pipeline Builder 的静态融合。
典型工作流编排拓扑
Pipeline Builder ──→ [LoRA Pipeline] ←── Load LoRA
                          │
                          └──→ Generate Media Latents → Decode Media Latent
节点外观预览
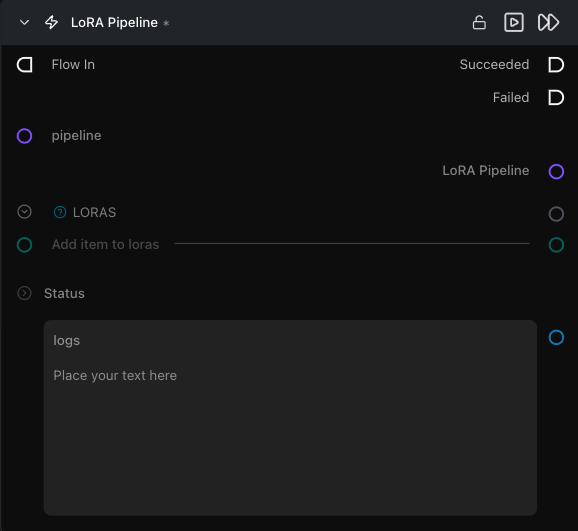
输入端口规范 (Inputs)
| 端口名称 | 数据类型 | 是否必填 | 详细功能与业务规范说明 |
|---|---|---|---|
pipeline |
Pipeline Config |
是 | 基础扩散管线凭据。来自上游 Pipeline Builder。该管线仅被引用与动态借用,底层结构未被修改——允许同时分线连入其他节点。 |
loras |
loras |
是 | 来自 Load LoRA 节点的一个或多个 LoRA 负载对象。接收列表形态;可直接连入多个 Load LoRA 节点的输出端口实现多层叠加。 |
输出端口矩阵 (Outputs)
| 端口名称 | 数据类型 | 详细功能与业务规范说明 |
|---|---|---|
lora_pipeline |
Pipeline Config |
携带了动态 LoRA 调度指令的衍生管线对象。与输入管线深度共享底层显存缓存——将其连入 Generate Media Latents 绝不会诱发管线重构。 |
logs |
str |
记录 LoRA 动态装配、激活时序与管线配置 Hash 指纹的详细日志。 |
避坑技巧与最佳实践 (Tips & pitfalls)
- 动态激活 LoRA 与静态融合 LoRA 具备本质物理区别:
- 静态融合 LoRA (Fused):通过 Pipeline Builder 的
loras端口注入,直接将权重加权熔铸进底模张量;修改其强度会使显存缓存全部失效并触发管线重构; - 动态激活 LoRA (Active):通过本节点挂载,在推理循环时临时介入;随心所欲微调权重,主模常驻显存永不释放。
- 必须至少连接一个 LoRA 节点:本算子要求
loras插槽必须具备至少一个有效输入源,否则在运行阶段会校验拦截。 - 共享缓存池的高并发优势:
lora_pipeline与上游输入pipeline完全共享底层底模的显存实例。你可以在同一个画布上兵分两路(一路连纯净管线,一路连挂载了 LoRA 的衍生管线)并发执行,而完全不需要占用双倍显存来加载两份底模! - 权重微调零开销响应:在调试过程中修改上游 Load LoRA 的
weight数值后再次点击 Run,节点会以毫秒级响应直接应用新权重,彻底摆脱漫长的管线重新初始化等待。
推荐延伸阅读
- Load LoRA — 负责从磁盘装载模型并提供
loras输入凭据 - Modular Diffusion Pipeline Builder — 提供上游未修改的基础
pipeline - Generate Media Latents — 核心消费端,接收
lora_pipeline执行去噪