Modular Diffusion Pipeline Builder 算子节点
加载并常驻缓存一个 🧨 Diffusers 管线对象,供画布下游的所有其他算子节点无缝复用。
算子所属分类:ModularDiffusion/Pipeline
核心速查 (TL;DR)
- 单次加载构建,无限复用推理 (Build once, generate many):始终将本节点置于扩散工作流的开端;将输出的
pipeline端口连入画布上下游所有依赖模型权重的 Modular Diffusion 算子(如 Generate Media Latent、VAE Encode/Decode、Create Noise 等); - 优先选定
provider提供方:所有其他子参数(目标模型仓库、运行时性能旋钮)均会根据所选的架构家族动态动态重新生成; - 智能基于配置指纹哈希缓存 (Hash-cached):管线在显存中由所有加载期参数(模型 ID、量化格式、LoRA 链)生成的 Hash 唯一标识。更改加载期参数会触发物理重构并更新缓存;而运行期参数(如提示词 Prompt、采样步数 Steps)的变动绝不会触发耗时的管线重新拉取与重构;
- 输出端口类型:
Pipeline Config。
典型工作流编排拓扑
[Pipeline Builder] → Create Noise Latents → Generate Media Latents → Decode Media Latent
节点外观预览
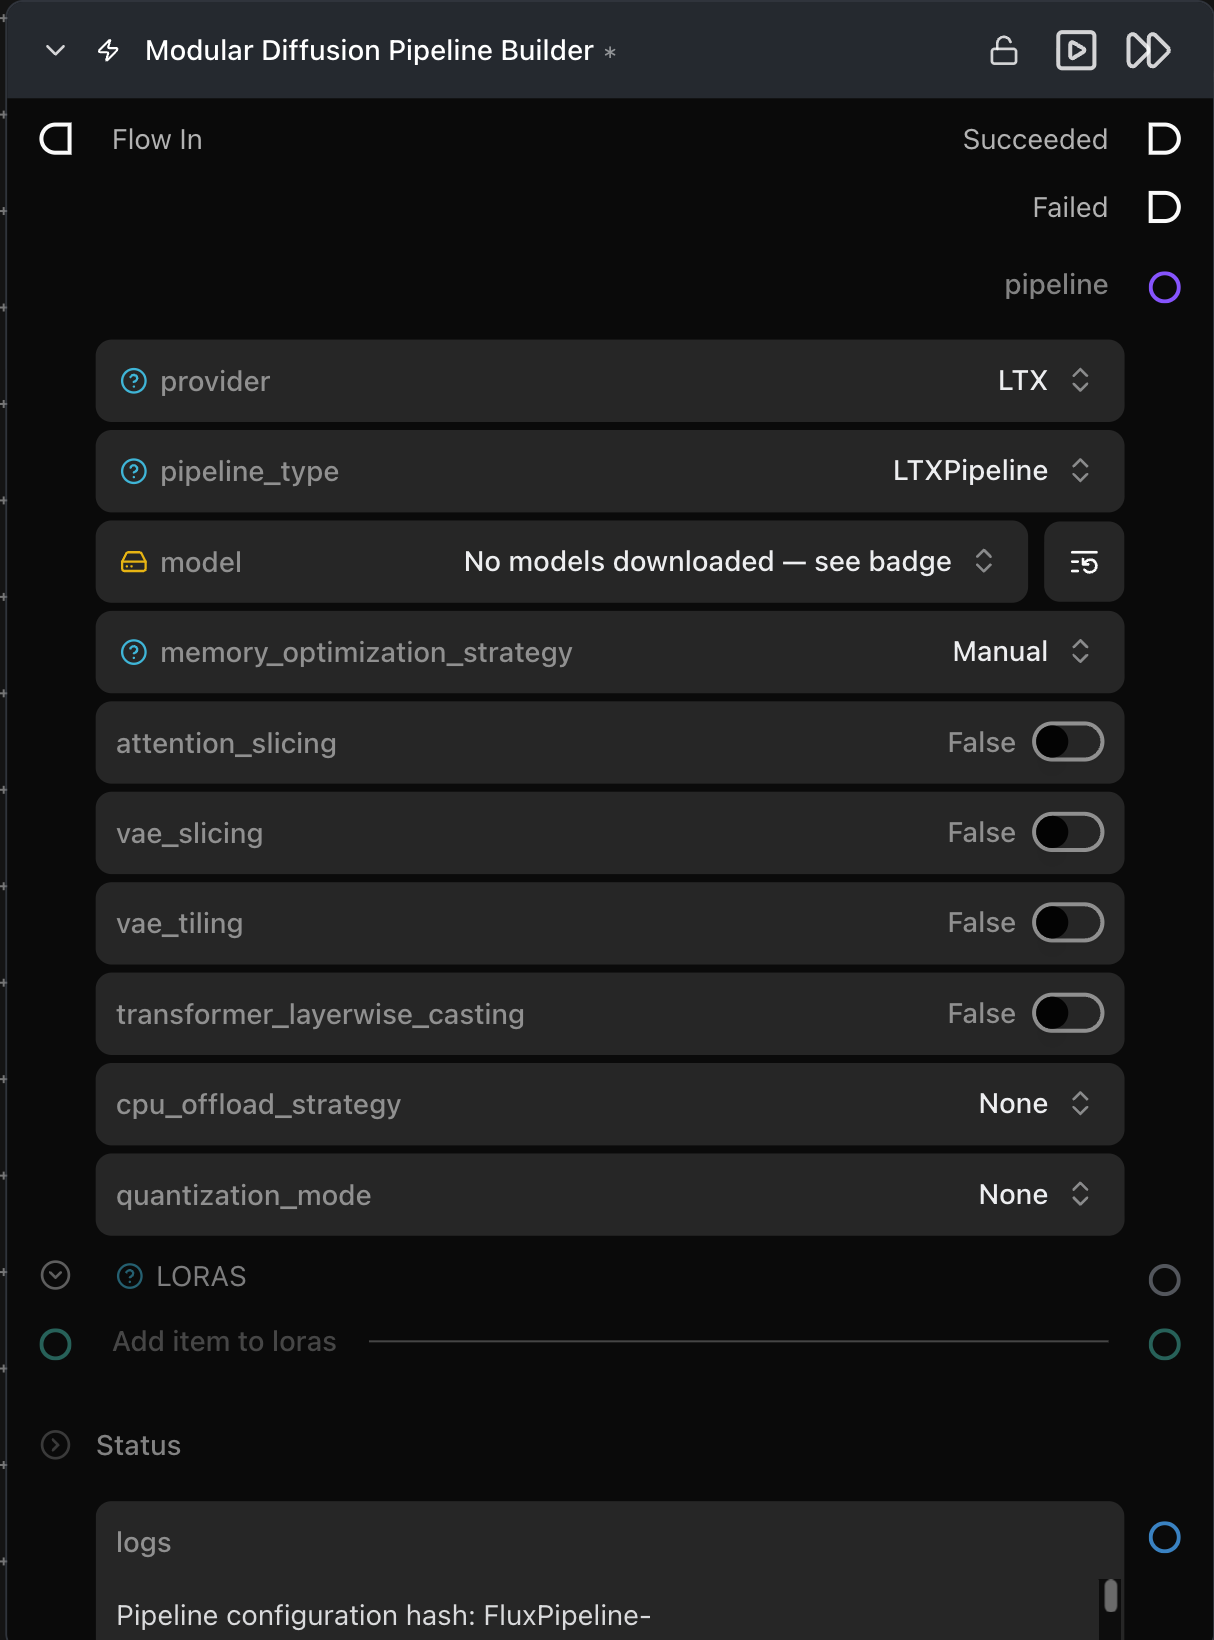
输入端口规范 (Inputs)
| 端口名称 | 数据类型 | 是否必填 | 详细功能与业务规范说明 |
|---|---|---|---|
loras |
loras |
否 | 连入一个或多个 Load LoRA 算子节点。多个 LoRA 将按连线顺序自动在管线内完成级联堆叠注入。 |
输出端口矩阵 (Outputs)
| 端口名称 | 数据类型 | 详细功能与业务规范说明 |
|---|---|---|
pipeline |
Pipeline Config |
包含在显存中缓存就绪的管线凭据对象。连入任何标有 pipeline 输入插槽的下游算子。 |
logs |
str |
管线构建全生命周期日志,包含底层解析出的唯一配置指纹 Hash。 |
属性参数调优 (Parameters)
管线主干配置组 (动态属性——变更 provider 时自动刷新重构)
| 参数名称 | 数据类型 | 详细业务功能与调优说明 |
|---|---|---|
provider |
下拉枚举 | 模型所属的架构家族:Flux、Flux2、Stable Diffusion、Stable Diffusion 3、Qwen、Z-Image、HunyuanVideo 1.5、LTX、LTX2、WAN。切换该项将完全置换下方所有动态参数。 |
pipeline_type |
下拉枚举 | 对应架构下的具体管线类(例如 FluxPipeline、WanImageToVideoPipeline)。决定了该管线具备的核心生成/编辑能力形态。 |
<model repo> |
Hugging Face 选择器 | Hugging Face 远程仓库 ID。仅支持 Diffusers 原生目录结构——单文件 .safetensors Checkpoint 无法直接挂载。 |
硬件显存调优组 (Memory optimization)
| 参数名称 | 数据类型 | 默认值 | 详细业务功能与调优说明 |
|---|---|---|---|
memory_optimization_strategy |
下拉枚举 | Manual |
显存调优模式。选 Automatic 会折叠隐藏下方微调项,并依据模型自动应用通用平衡配置;选 Manual 开启全部手动控制。 |
attention_slicing |
bool |
False |
自注意力运算切片:极具性价比的显存节省策略,仅带来极小幅吞吐速度下降。 |
vae_slicing |
bool |
False |
VAE 分块切片:将潜变量以批次为 1 逐个解码,在大 Batch Size 或大画幅渲染时能有效防止 VAE 爆显存。 |
transformer_layerwise_casting |
bool |
False |
Transformer 逐层精度动态转换:在内存中维持低精度存储,在计算前线逐层升阶。 |
cpu_offload_strategy |
下拉枚举 | None |
CPU 内存置换卸载策略:Model(以子模块为单位卸载)或 Sequential(以单层 Layer 循环卸载)——在特定模块闲置时移入内存以腾出 VRAM,以推理耗时置换极限显存容量。 |
quantization_mode |
下拉枚举 | None |
量化档位:fp8 / int8 / int4(底层基于 optimum-quanto 或 bitsandbytes 驱动)。显著压低 Transformer 显存消耗,微幅牺牲微小画质。 |
注:仅开启实际必要的优化项——每项功能皆以不同程度的计算开销换取更低的物理显存门槛。
避坑技巧与最佳实践 (Tips & pitfalls)
- 引擎重启后的管线状态:管线缓存仅驻留在进程内存中;重启引擎后无需担心,下次点击运行 (Run) 时节点会自动完成静默加载重析。
- 初次加载报显存溢出 (CUDA OOM):模型基础权重超出了显卡的物理显存容量上限。请按以下优先级次序尝试优化组合:
- 将
quantization_mode设为int8或int4; - 将
cpu_offload_strategy设为Model(将闲置组件暂存至主机内存); - 勾选
vae_slicing(削减解码阶段的瞬时显存尖峰)。 - LoRA 权重未生效的排查路径:
- 确认该 LoRA 是否为当前
pipeline_type所匹配的架构训练所得(例如 Flux 专用的 LoRA 绝对无法注入 WAN 视频管线); - 检查 Load LoRA 节点的输出端口是否准确连入了本节点的
loras输入插槽。 - 务必在配置其他参数前先锁定
provider:更改provider会彻底重置下方所有衍生参数;尽管同名参数的连线会被智能保留,但输入框数值会被重置为出厂默认值。在构建初期率先确定架构提供方,能避免重复劳动。
推荐延伸阅读
- Configure ControlNet · ControlNet Pipeline — 为已构建的管线注入空间结构控制网
- Load LoRA — 挂载微调 LoRA 权重至本构建器
- Generate Media Latents — 消费本节点
pipeline凭据的核心去噪步进算子